
Seunghyeon Ji
AI, 검색
개요
콕스웨이브 AX팀은 온라인 교육 플랫폼 사용자들의 학습을 도와주는 AI Tutor인 EduTAP을 서비스하고 있어요. 강의를 잘 수강했는지 점검할 수 있는 퀴즈 컨텐츠 뿐만 아니라, 이해되지 않는 부분을 AI에게 물어보고 강의 문서를 바탕으로 실시간 답변을 받는 채팅 기능도 제공합니다. 이 때 AI가 질문과 관련 없는 엉뚱한 문서를 바탕으로 답변을 제공한다면 사용자 학습을 방해하게 돼요.
이 글에서는 AI가 사용자 질문에 가장 적절한 문서를 바탕으로 답변하기 위해 RAG 아키텍처를 사용하며 검색 정확도를 끌어올린 과정을 소개해요. RAG를 잘 모르시는 분도 부담 없이 읽으실 수 있도록, 복잡한 이론보다는 저희가 실제로 겪었던 문제와 해결 과정 중심으로 쉽게 풀어봤어요.
—
RAG, 쉽게 이해하기
생성형 AI는 자연스러운 문장을 만들고 일반적인 지식을 설명하는 데 뛰어나요. 하지만 서비스에 새로 등록된 강의 교재, 문제집, 해설 자료까지 알고 있지는 않아요. 이 상태에서 수강생이 질문을 던지면 답변을 포기하거나 거짓 답변을 생성하는 문제가 발생해요.

이 두 가지 문제를 해결하기 위해 저희가 선택한 방법이 바로 RAG였습니다. AI의 내부 기억에만 의존하지 않고, 수강생의 질문에 맞는 교재 부분을 데이터베이스에서 먼저 정확하게 찾아와 프롬프트로 제공한 뒤 답변을 생성하도록 만드는 방식이에요.
—
Dense Search 도입
RAG에서 질문에 맞는 교재를 찾아오려면 컴퓨터가 문장의 의미를 비교할 수 있어야 해요. 하지만 컴퓨터는 글자 자체의 뜻을 모르기 때문에, 텍스트를 숫자로 변환해 거리를 계산하는 방식을 사용해요.
벡터: 문장의 의미를 공간 속 위치로 나타낸 일련의 숫자 좌표예요.
임베딩: 사람이 쓰는 글자를 이러한 벡터 좌표로 변환하는 작업이며, 이를 전담하는 AI를 임베딩 모델이라고 불러요.
벡터 검색: 질문 벡터와 공간상에서 가장 가까운 위치에 있는 문서를 수학적으로 찾아내는 기술이에요.
벡터 검색 중에서 가장 널리 쓰이는 방식 중 하나가 Dense Search예요. 단어가 정확히 일치하지 않더라도 문장 전체의 문맥과 뉘앙스가 비슷하면 서로 가까운 위치에 배치하는 방식이에요.

만약 수강생이 “3번 문제 왜 2번이 답이야?”라고 질문하더라도, 교재 속 “3번 문항 정답 도출 과정 및 해설” 문서는 표현이 조금 다를 뿐 의미가 비슷하기 때문에 공간상에서 매우 가까운 위치에 배치돼요. 반면 관련 없는 “수강 취소 및 환불 규정 안내” 같은 문서는 공간상에서 멀리 떨어지게 돼요.
따라서 수강생이 교재에 적힌 정확한 문장이나 전문 용어를 그대로 쓰지 않더라도, Dense Search는 질문의 뉘앙스를 파악해 관련된 해설 자료를 효과적으로 찾아올 수 있어요.
저희 팀은 강의 자료 속에서 수강생 질문에 맞는 문서를 찾아내기 위해, 가장 먼저 OpenAI의 text-embedding-3-large 모델을 활용한 Dense Search 파이프라인을 구축했어요. 일반적인 개념 질문에서는 준수한 검색 성능을 보였지만 정확한 식별자가 중요한 질문은 별도의 보완이 필요했어요.
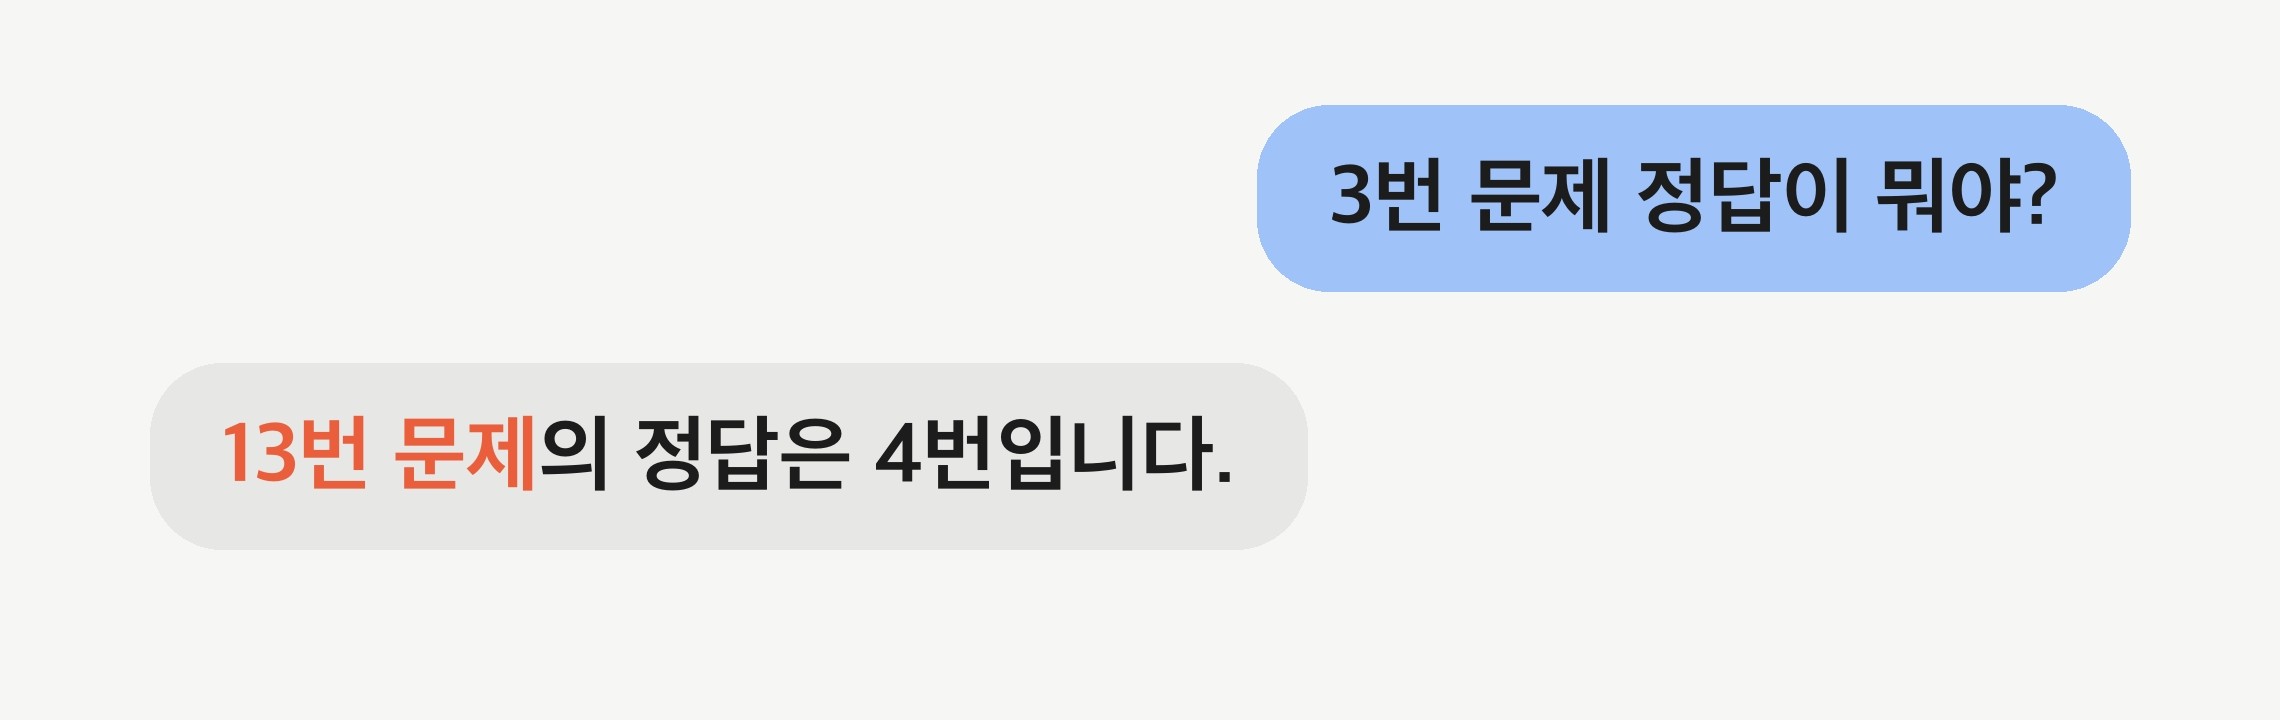
예를 들어 수강생이 “3번 문제 정답 알려줘”라고 질문할 때, Dense Search만으로는 3번과 13번처럼 형식과 문맥이 유사한 문제를 충분히 엄격하게 구별하지 못할 수 있어요. 같은 교재 안에 있는 시험 문제들은 대부분 “다음 중 옳은 것은?”, “정답 및 해설”처럼 문장의 형식과 쓰이는 표현이 거의 비슷해요.
이 상태에서 수강생이 “3번 문제 정답 알려줘”라고 질문하면, AI는 핵심 단어인 3보다 문장의 문제, 정답, 시험 등의 문맥을 더 크게 인식해 버려요. 그 결과, 지문 구성이나 해설 문맥이 유사하다는 이유만으로 13번 문제 문서가 3번 문제보다 의미상 더 가깝다고 판단해 엉뚱하게 13번 문서를 1등으로 찾아오는 문제가 발생하게 돼요.
—
Sparse Search 도입
Dense Search가 문장의 의미와 문맥을 비교한다면, Sparse Search는 문맥을 보지 않고, 질문에 들어 있는 글자가 문서에 실제로 존재하는지 여부만 엄격하게 따져요. 이 기준으로 대조하면 3과 13은 완전히 다른 글자예요. 13번 문서에서는 질문의 핵심 토큰인 3이 없으므로, 어휘 일치 점수를 전혀 얻지 못하게 돼요.
하지만 글자를 그대로 대조하는 방식에도 걸림돌이 있었어요. 같은 3번 문제라도 사람과 교재마다 표기 방식이 제각각이라는 점이에요.
교재에는 문제 03이나 문제 3으로 적혀 있는데, 수강생은 3번 문제로 질문할 수 있어요. 글자 그대로만 보면 이 표현들은 서로 다른 단어로 취급되어 검색이 실패할 수 있어요. 특히 문제 3처럼 숫자만 남는 표기에서는, 3이 페이지 번호나 보기 번호로도 교재 곳곳에 나오기 때문에 그 자체로는 식별력이 떨어지게 돼요.
이를 해결하기 위해 문제 03, 문제 3, 3번 문제처럼 다양한 형태로 나타나는 문제 번호 표기를 모두 문제3이라는 하나의 식별자 토큰으로 정규화했어요. 그 결과 3번과 13번 문제는 각각 문제3, 문제13이라는 완전히 다른 고유 식별자를 갖게 되어 번호가 맞는 문서가 우선 검색돼요.

—
Hybrid Search 결합
Sparse Search만 사용하면 또 다른 문제가 생겨요. 수강생은 교재와 다른 표현으로 질문할 수 있기 때문이에요.
수강생 질문: “수요 곡선이 왜 우하향해?”
교재 본문: “가격 하락에 따른 소비량 증대 원리”
두 문장에 공통 단어가 거의 없으면 Sparse Search만으로는 관련 문서를 찾기 어려워요. 반대로 Dense Search는 이런 어휘 불일치에 강해요.
그래서 EduTAP은 정확한 표기를 확인하는 Sparse Search과 의미적 유사성을 찾는 Dense Search을 함께 사용하는 Hybrid Search를 적용했어요. 문제 번호나 전문 용어가 포함된 질문에서는 Sparse 검색이 정확한 표기를 잡고, 수강생의 구어체 질문처럼 표현이 달라진 경우에는 Dense Search가 의미적으로 가까운 자료를 보완해 줘요.
두 검색 방식의 결과를 합칠 때는 가중치가 필요해요. Dense Search와 Sparse 검색은 점수의 범위와 분포가 서로 다르기 때문에, 원래 점수를 그대로 더하면 어느 한쪽의 결과가 과도하게 반영될 수 있어요. EduTAP은 실제 수강생 질문으로 만든 검증 데이터에서 여러 비율을 비교했고, 현재 교육 자료에서는 Sparse 80%, Dense 20%를 반영했을 때 가장 높은 검색 성능을 확인했어요.
시험 대비 자료에는 문제 번호, 전문 용어처럼 정확한 식별자가 포함된 질문이 많았어요. 이런 환경에서는 키워드 일치의 비중을 조금 더 높게 두는 편이 유리했어요. 다만 이 비율이 모든 서비스에 통하는 정답은 아니에요. 자료의 성격과 실제 질문 유형이 바뀌면 최적의 비율도 달라질 수 있으므로, 서비스 데이터로 계속 검증하는 과정이 필요해요.
—
마치며
AI Tutor에서 중요한 것은 복잡한 모델을 도입하는 것만이 아니에요. 수강생이 “3번 문제 설명해 줘”라고 질문했을 때, 현재 강의의 3번 문제를 찾아 근거와 함께 답하는 기본이 먼저 갖춰져야 해요.
EduTAP은 의미를 이해하는 Dense Search 뿐만 아니라 BM25 기반의 Sparse 검색, 현재 시청 강의로 범위를 좁히는 메타데이터 필터, 그리고 최종 후보 문서를 엄격히 선별하는 리랭킹 파이프라인을 유기적으로 함께 적용하고 있어요. 앞으로도 실제 수강생 질문과 검색 결과를 바탕으로, 검색 정확도를 계속 개선해 나갈 예정이에요.